
功能
能生成图片、视频和音频的聊天模型
在 ClawAI 中,Grok、GPT 或 Gemini 等聊天模型可以通过工具生成图片、视频和音频,等待生成结果,然后围绕结果写出最终回答,费用从套餐额度或按量付费余额中计量。
所有功能 · 最近审核:
在应用中查看
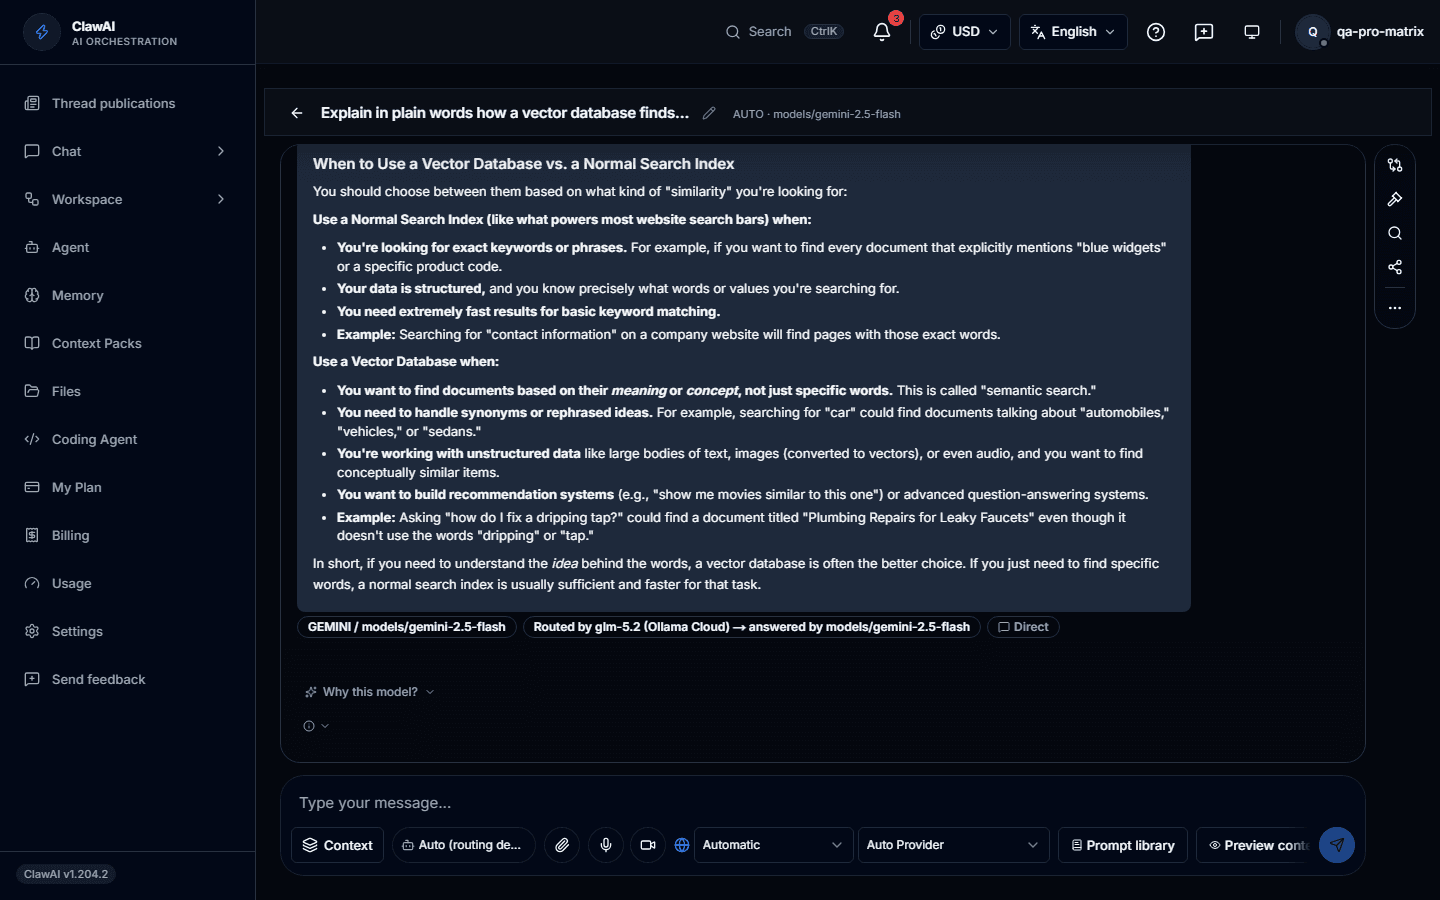
每个回答都会显示由哪个模型撰写以及原因。 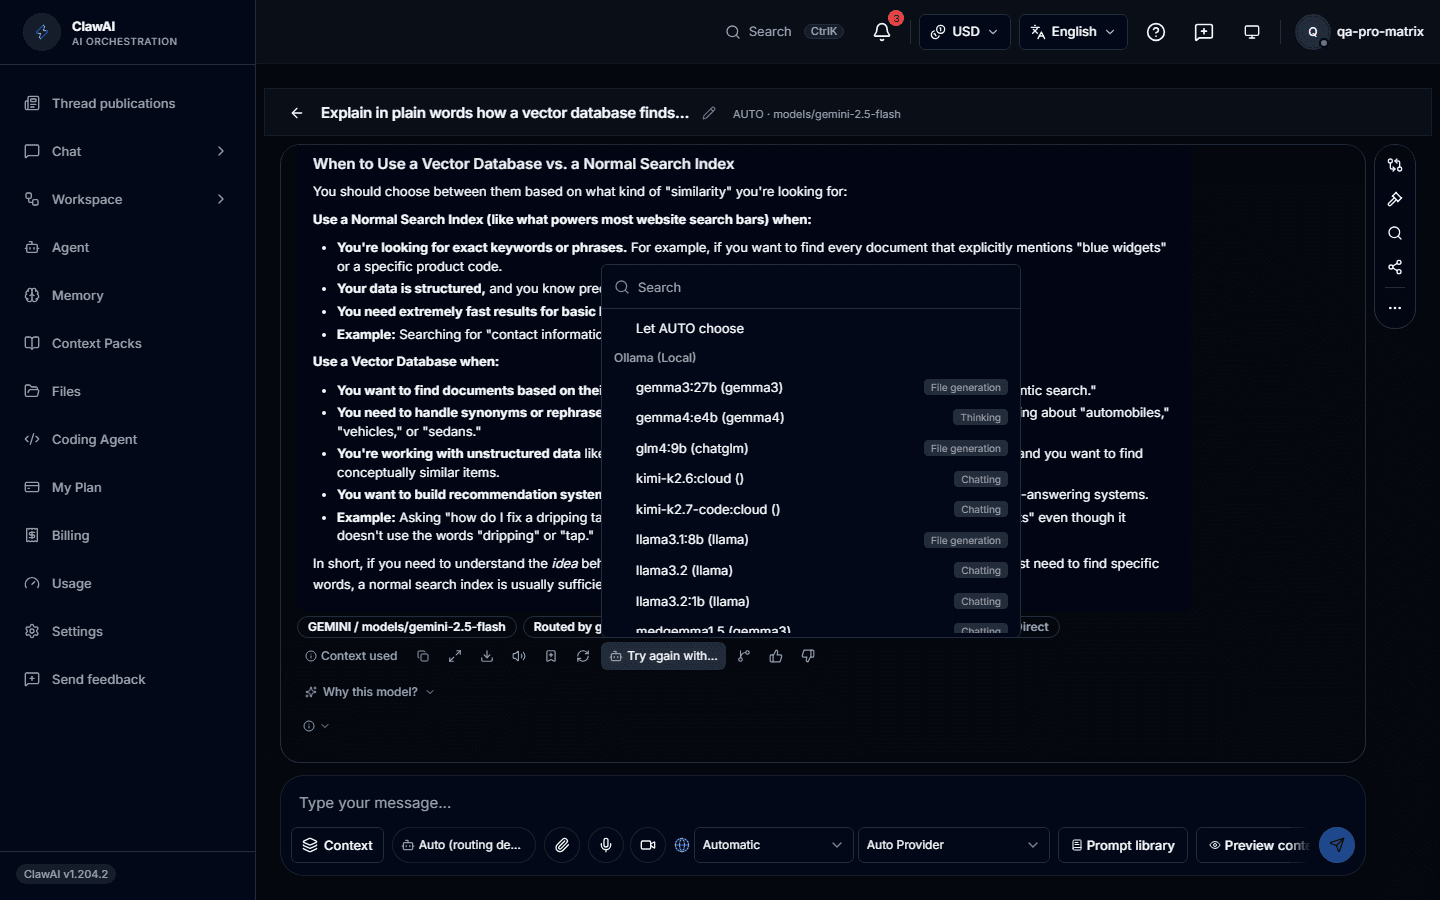
自己选择模型,或让 AUTO 来选。
模型提出请求,ClawAI 生成,模型作答
当你的消息需要媒体时,聊天模型可以调用三个工具之一:生成图片、生成视频或生成音频。ClawAI 运行媒体模型,等待其完成,并把结果交还给同一个聊天模型,所以你读到的回复出自看过生成结果的模型。完成的图片、视频或音频显示在回复下方。无法调用工具的模型仍使用原来的快捷方式,由另一个媒体模型来回应请求。
适用于 Grok、GPT 和 Gemini
任何支持工具调用的聊天模型都可以使用这些工具,包括 Grok、GPT 和 Gemini 模型。像 Claude 这样自身不生成媒体的模型也可以请求媒体,因为媒体由工具背后专门的图片、视频和音频模型生成,而不是由聊天模型生成。
图片、视频和音频
图片来自 Gemini、OpenAI 或 xAI 的图片模型,视频来自 Veo 或 Grok Imagine,音频可以是语音(OpenAI 或 Gemini 的声音)或短音乐(Gemini Lyria)。可用的模型取决于运营方接入了什么。聊天模型可以指定模型,但只能是平台已知列表中的模型;其他情况会回退到默认模型。
等待、限制与费用
生成与其他生成一样计量:从你的套餐额度或按量付费余额中扣除,两者都不足时会被拒绝。生成媒体的这一轮不会逐字流式输出,因为模型需要等待结果。一次回答最多生成两项,对比视图中一条消息最多生成三项,每一项的等待时间都有上限。
常见问题
- 哪些聊天模型可以生成媒体?
- 任何支持工具调用的聊天模型,例如 Grok、GPT 和 Gemini 模型。媒体由工具背后的图片、视频和音频模型生成,因此像 Claude 这样自身不生成媒体的模型也可以请求。
- 在哪里可以使用?
- 在普通聊天和对比通道中。其他编排实验室(共识、升级、N 选一等)暂时不提供媒体工具,仍保持原来的行为:图片请求交给图片模型。
- 费用是多少?
- 每次生成都会从你的套餐额度或按量付费余额中计量,另加聊天模型自身的令牌。定价页面列出了每个套餐包含的内容。
与其相信我们的话,不如亲自试试
聊天模型调用 generate_image、generate_video 和 generate_audio;图片服务生成媒体,同一个聊天模型写出回复,计量方式与其他生成相同。