
Guias
Guias: IA multimodelo, roteamento e orquestração
Explicações claras das técnicas por trás da IA multimodelo: roteamento, consenso, verificação, RAG, memória e modelos de pesos abertos no seu próprio hardware.
Última revisão:
Veja no app
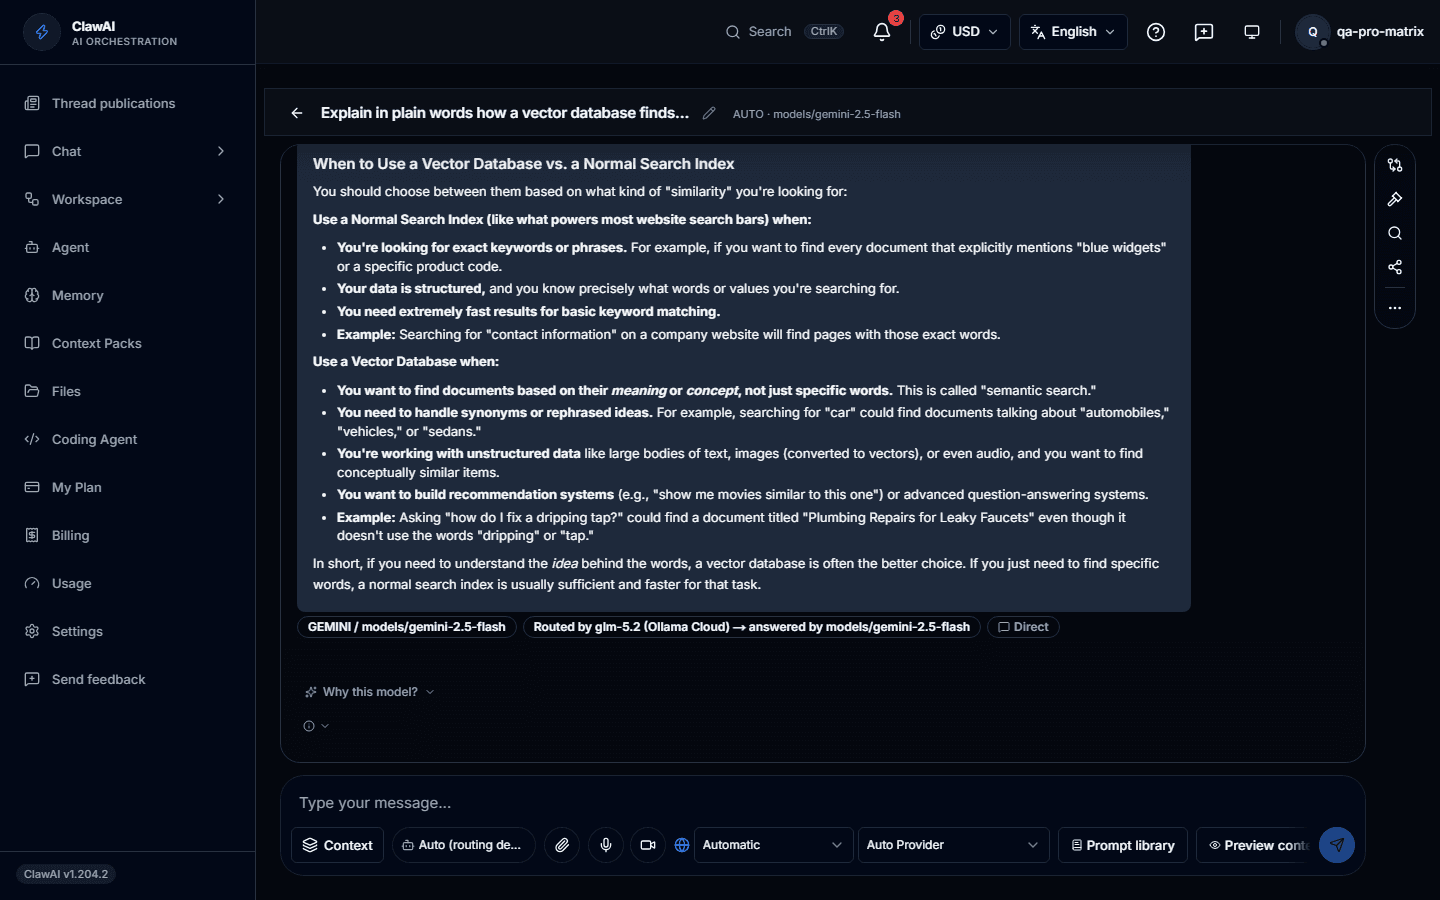
Cada resposta mostra qual modelo a escreveu e por quê.
Escolha um conceito
- Como os modelos de linguagem geram respostasComo um prompt vira tokens, probabilidades e uma resposta gerada.
- O que são tokens de IA?A unidade que um modelo realmente lê e escreve, e por que uma contagem exata precisa do tokenizador dele.
- O que temperature e top-p controlam?O que temperature e top-p realmente mudam numa resposta, e o que eles não conseguem mudar.
- O que são embeddings?Como o texto vira um vetor de números, e por que isso torna possível buscar por significado.
- Prompting vs. RAG vs. fine-tuning: qual a diferença?Três soluções diferentes para três problemas diferentes, e por que muitos produtos nunca precisam da terceira.
- Como funciona de verdade a chamada de ferramentas na IA?O modelo nunca executa nada — ele propõe uma chamada, e sua aplicação decide o que acontece depois.
- O que são saídas estruturadas de IA?Pedir JSON a um modelo é uma solicitação; só alguns mecanismos garantem de verdade que ele bate com seu esquema.
- Por que a IA tem alucinações?Por que um modelo afirma uma resposta errada com a mesma confiança de uma certa — e o que realmente reduz isso.
- O que é IA multimodelo?Usar vários modelos num mesmo fluxo em vez de se prender a um só.
- O que é orquestração de LLM?A camada que decide qual modelo roda, em que ordem e o que acontece com o resultado.
- O que é roteamento de modelos de IA?Enviar cada requisição a um modelo escolhido por tarefa, custo, privacidade ou latência.
- O que é fallback entre modelos?O que deve acontecer quando o primeiro modelo cai, é limitado ou recusa.
- O que é consenso entre modelos de IA?Fazer a mesma pergunta a vários modelos e usar a concordância como sinal.
- O que é melhor de N?Gerar várias respostas candidatas e ficar com a melhor.
- O que é um juiz de IA?Usar um modelo para pontuar respostas de outros, e onde isso falha.
- O que é verificação de respostas de IA?Conferir uma resposta contra algo diferente do modelo que a produziu.
- O que é uma janela de contexto?A memória de trabalho de uma única requisição, e por que não é memória.
- O que é geração aumentada por recuperação?Recuperar seus próprios documentos e colocá-los diante do modelo.
- O que é memória num assistente de IA?O que persiste entre conversas, e quanto isso custa.
- O que são pacotes de contexto?Pacotes de contexto reutilizáveis que você anexa a uma conversa de propósito.
- O que é IA local?Rodar um modelo em hardware que você controla, e o que isso muda de fato.
- O que são modelos de pesos abertos?Modelos cujos pesos você pode baixar — e o que «aberto» significa e não significa.
- O que é IA auto-hospedada?Rodar a aplicação inteira por conta própria, não apenas o modelo.
- Ollama ou llama.cppDuas formas de rodar modelos de pesos abertos localmente, e para que serve cada uma.
- IA em nuvem ou IA localA troca real: capacidade e conveniência contra controle e formato de custo.
- Agente de IA ou chatbotA diferença entre responder a você e fazer algo por você.
- Como avaliar modelos de IA para o seu próprio usoO que realmente testar antes de confiar seu trabalho a um modelo — não um número de ranking.
- Como ler benchmarks de IA sem se deixar enganarO que um número de benchmark realmente mede, e as formas como pode te enganar antes mesmo de você começar a testar.
- O que é injeção de prompt?Um texto que não é seu ainda assim pode dar instruções ao modelo — o que isso significa e por que um modelo mais inteligente não resolve isso por completo.
- Privacidade e retenção de dados de IA, explicadasO que realmente acontece com o que você digita num produto de IA — quem vê, se treina um modelo, e por quanto tempo fica guardado.