
模型提供商
ClawAI 中的本地开放权重 AI 模型
通过 ClawAI,用 Ollama 或 llama.cpp 自行运行开放权重模型,而不是把请求发送给云端提供商。这一机制是什么,以及它与本页其他云端提供商有何不同。
所有提供商 · 最近更新:
在应用中查看
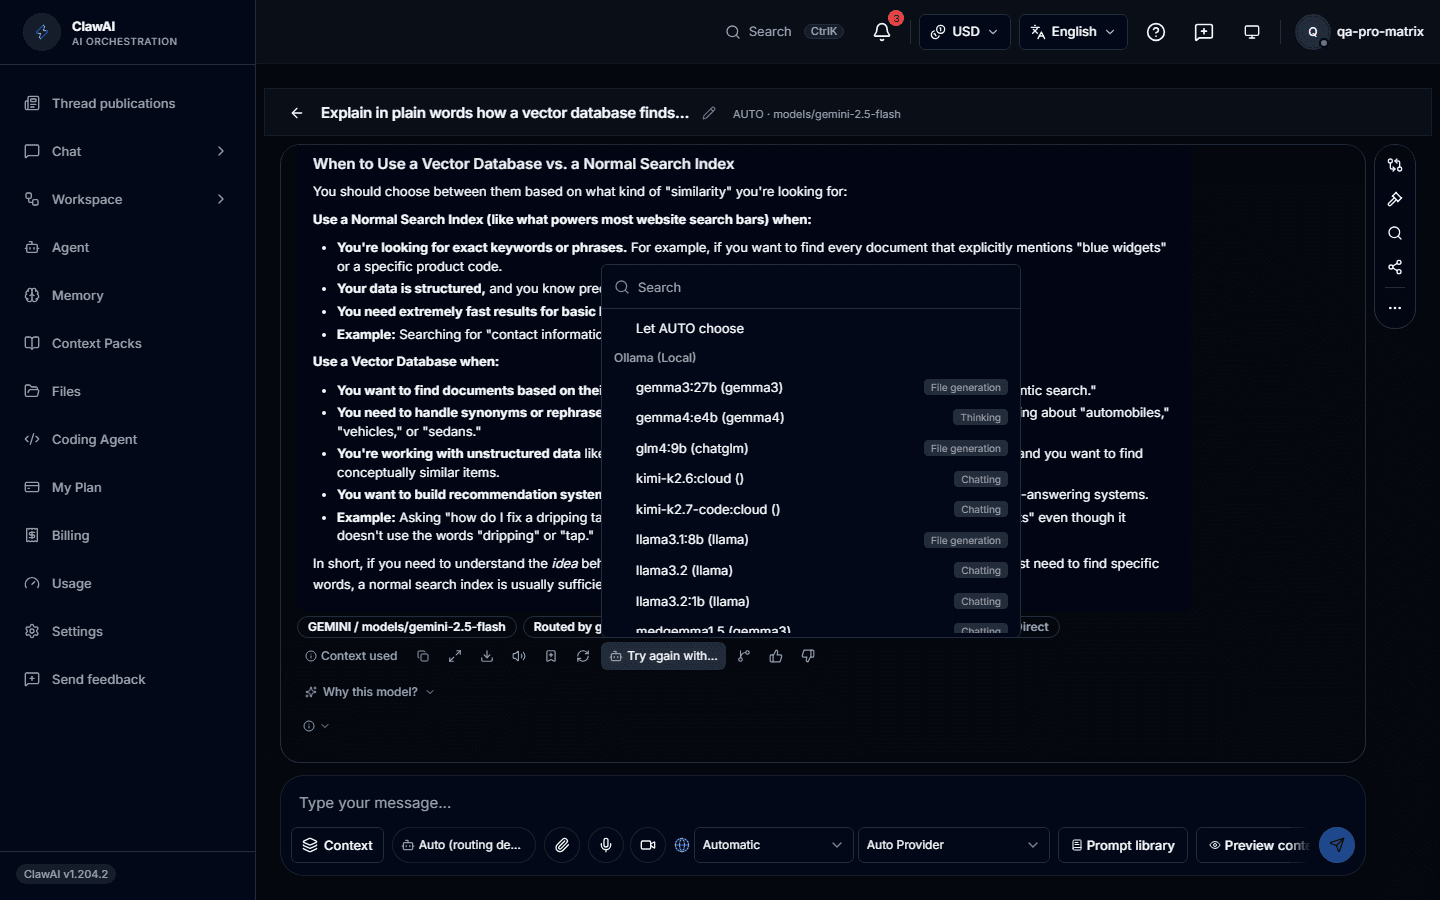
自己选择模型,或让 AUTO 来选。
ClawAI 可路由到的模型
GLM 5.3
GLM 5.3 Flash
GLM 5.2
Mistral Large 4
Nemotron 3 Super
Nemotron 3 Ultra
Beam
clef:27b
Deepseek v4 pro:0813
Deepseek v4.1 Flash
Deepseek v4.1 flash:1017
gemma4:31b
GPT oss:120b
GPT oss:20b
Kimi k2.6
Kimi k2.7 Code
Kimi k3
Kimi k3.1 Pro
Mimo v2.6 Flash
Mimo v2.6 Pro
Minimax m3
Minimax m3.1 Flash
Muse Spark Open
此列表直接读取 ClawAI 当前可路由的模型,因此会随着服务商接入或模型下线而变化。 请在定价页确认实时目录
本地运行模型究竟改变了什么
本站的云端提供商在自己的基础设施上运行模型,并按请求收费。而 Ollama 和 llama.cpp 是把一个开放权重模型加载到你自己掌控的硬件上——你自己的电脑,或者你运营的服务器——这样请求就不会离开这台设备。这改变的是谁能看到这个请求,而不是模型的能力本身;本地运行的开放权重模型,和本系列其他页面列出的任何云端提供商都是不同性质的东西,不能简单地互相替代。
Ollama 和 llama.cpp 是两个不同的工具
两者都是 ClawAI 真实接入的适配器,但适用的场景不同——Ollama 的重点是用合理的默认设置轻松拉取和运行模型,而 llama.cpp 则以更繁琐的手动配置为代价,提供对模型运行方式更直接的控制。完整对比见下方链接的“Ollama 与 llama.cpp 对比”,这里不再重复。
该运行哪个开放权重模型
本页刻意不指名任何具体的开放权重模型,因为这个领域的变化速度超过了一个静态页面能够跟上的程度,一条过时的推荐比没有推荐更糟。下方链接的“什么是本地优先 AI”对开放权重模型,以及与云端提供商之间的取舍,做了比产品页面更深入的说明。
常见问题
- 通过 ClawAI 使用本地 AI 需要付费吗?
- ClawAI 不会像对云端提供商那样,对本地运行的模型按 token 收费,因为这里并没有被计费的云端提供商——成本就是你本来就在使用的那部分硬件。具体套餐规则请在定价页确认。
- 我该运行哪个开放权重模型?
- 本页不做推荐——见下方链接的“什么是本地优先 AI”,了解该如何思考这个选择,因为哪个模型合适取决于你的硬件和任务,这不是一个静态页面能够负责任地持续跟踪的。
- 本地运行的模型能力比得上云端模型吗?
- 这完全取决于具体的开放权重模型和你的硬件,本页不会给出笼统的定论。见下方链接的“如何评估 AI 模型”,了解如何针对你自己的工作负载去检验。
不必只听我们说,亲自试试看
ClawAI 的 Ollama 和 llama.cpp 适配器都是真实上线的连接器——仅本地路由模式会让每一次请求都留在你自己掌控的硬件上。