
Разборы
Разборы: мультимодельный ИИ, маршрутизация, оркестрация
Понятные объяснения техник мультимодельного ИИ: маршрутизация, консенсус, проверка ответов, RAG, память и модели с открытыми весами на своём железе.
Последняя проверка:
Посмотрите в приложении
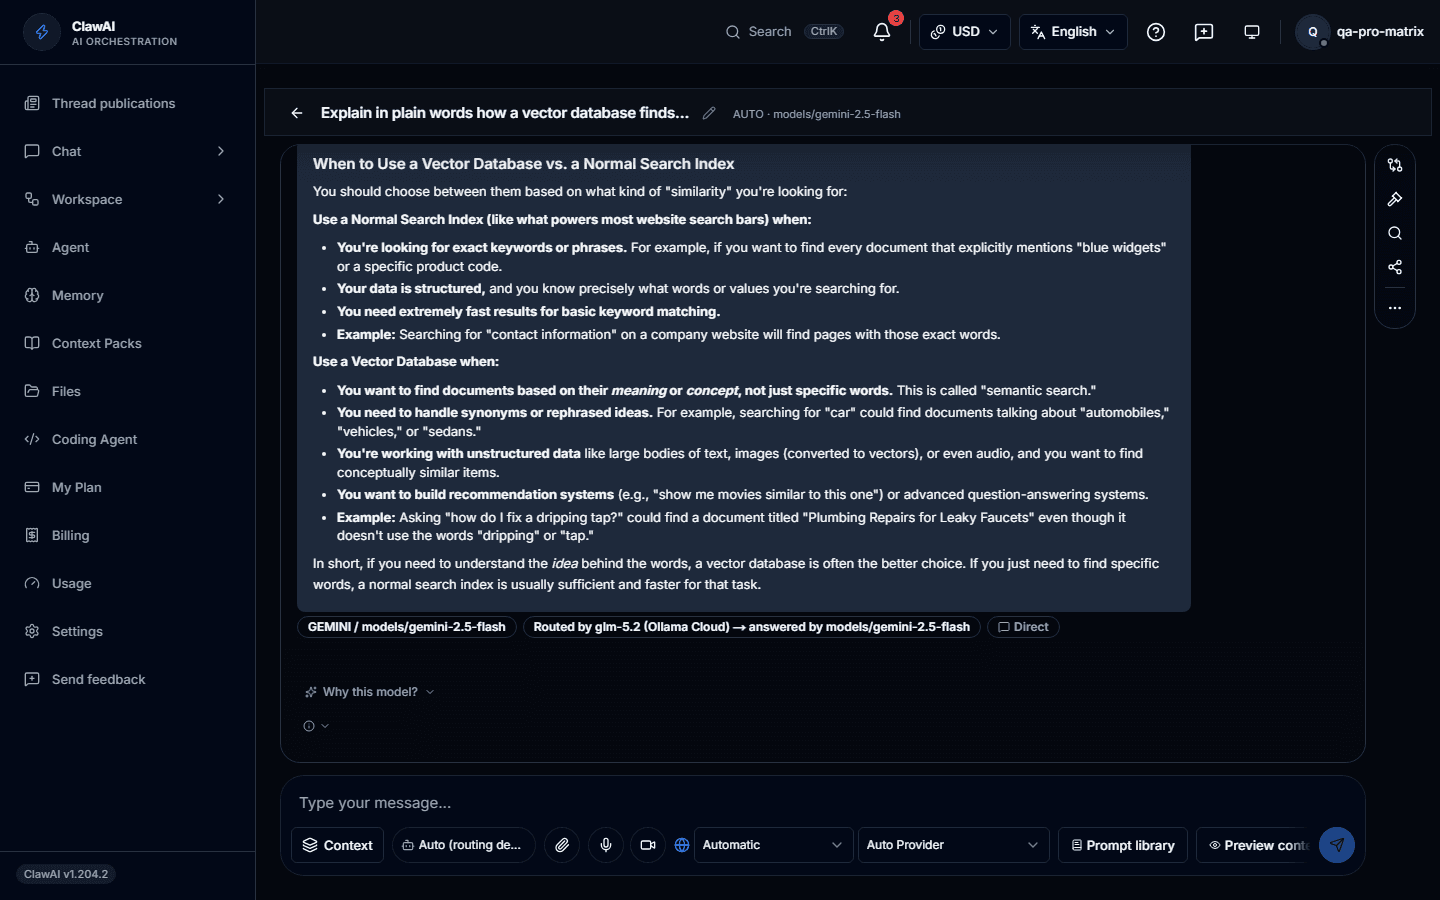
Каждый ответ показывает, какая модель его написала и почему.
Выберите тему
- Как языковые модели генерируют ответыКак запрос превращается в токены, вероятности и сгенерированный ответ.
- Что такое токены в ИИ?Единица, которую модель на самом деле читает и пишет, и почему точное число требует её собственного токенизатора.
- Что контролируют температура и top-p?Что температура и top-p на самом деле меняют в ответе — и что они изменить не могут.
- Что такое эмбеддинги?Как текст превращается в вектор чисел и почему это делает возможным поиск по смыслу.
- Промптинг, RAG и дообучение: в чём разница?Три разных способа решить три разные проблемы, и почему многим продуктам никогда не нужен третий.
- Как на самом деле работает вызов инструментов в ИИ?Модель никогда ничего не выполняет сама — она предлагает вызов, а ваше приложение решает, что делать дальше.
- Что такое структурированные выводы ИИ?Просьба к модели вернуть JSON — это запрос; лишь некоторые механизмы по-настоящему гарантируют соответствие вашей схеме.
- Почему ИИ галлюцинирует?Почему модель заявляет неверный ответ с той же уверенностью, что и верный — и что на самом деле это снижает.
- Что такое мультимодельный ИИ?Использовать несколько моделей в одном рабочем процессе вместо привязки к одной.
- Что такое оркестрация LLM?Слой, который решает, какая модель запускается, в каком порядке и что происходит с ответом.
- Что такое маршрутизация моделей ИИ?Отправлять каждый запрос модели, выбранной по задаче, цене, приватности или задержке.
- Что такое резервный переход между моделями?Что должно произойти, когда первая модель недоступна, ограничена или отказала.
- Что такое консенсус моделей ИИ?Задать один вопрос нескольким моделям и использовать их согласие как сигнал.
- Что такое «лучший из N»?Сгенерировать несколько вариантов ответа и оставить лучший.
- Что такое ИИ-судья?Поручить модели оценивать ответы других моделей — и где это ломается.
- Что такое проверка ответов ИИ?Проверять ответ чем-то отличным от модели, которая его написала.
- Что такое контекстное окно?Рабочая память одного запроса — и почему это не память.
- Что такое генерация с поиском по документам?Находить свои документы и класть их перед моделью.
- Что такое память ИИ-ассистента?Что сохраняется между разговорами и во сколько это обходится.
- Что такое наборы контекста?Многоразовые наборы контекста, которые вы осознанно прикрепляете к разговору.
- Что такое локальный ИИ?Запуск модели на своём железе — и что это меняет на самом деле.
- Что такое модели с открытыми весами?Модели, чьи веса можно скачать, — и что «открытый» значит, а что нет.
- Что такое self-hosted ИИ?Держать у себя всё приложение, а не только модель.
- Ollama или llama.cppДва способа запускать модели с открытыми весами локально и для чего годится каждый.
- Облачный ИИ или локальный ИИНастоящий размен: возможности и удобство против контроля и формы затрат.
- ИИ-агент или чат-ботРазница между «ответить вам» и «сделать за вас».
- Как оценивать модели ИИ для собственных задачЧто на самом деле нужно проверить, прежде чем доверить модели свою работу — а не число из рейтинга.
- Как читать бенчмарки ИИ, не поддаваясь заблуждениюЧто на самом деле измеряет число из бенчмарка и как оно может ввести вас в заблуждение ещё до начала тестирования.
- Что такое инъекция промпта?Текст, который написали не вы, всё равно может дать модели инструкции — что это значит и почему более умная модель не решает это полностью.
- Приватность и хранение данных ИИ: объяснениеЧто на самом деле происходит с тем, что вы вводите в ИИ-продукт — кто это видит, обучает ли это модель и как долго это хранится.