
Explications
Comprendre l’IA multimodèle, le routage et l’orchestration
Des explications claires des techniques derrière l’IA multimodèle : routage, consensus, vérification, RAG, mémoire et modèles à poids ouverts sur votre matériel.
Dernière vérification:
Voir dans l’application
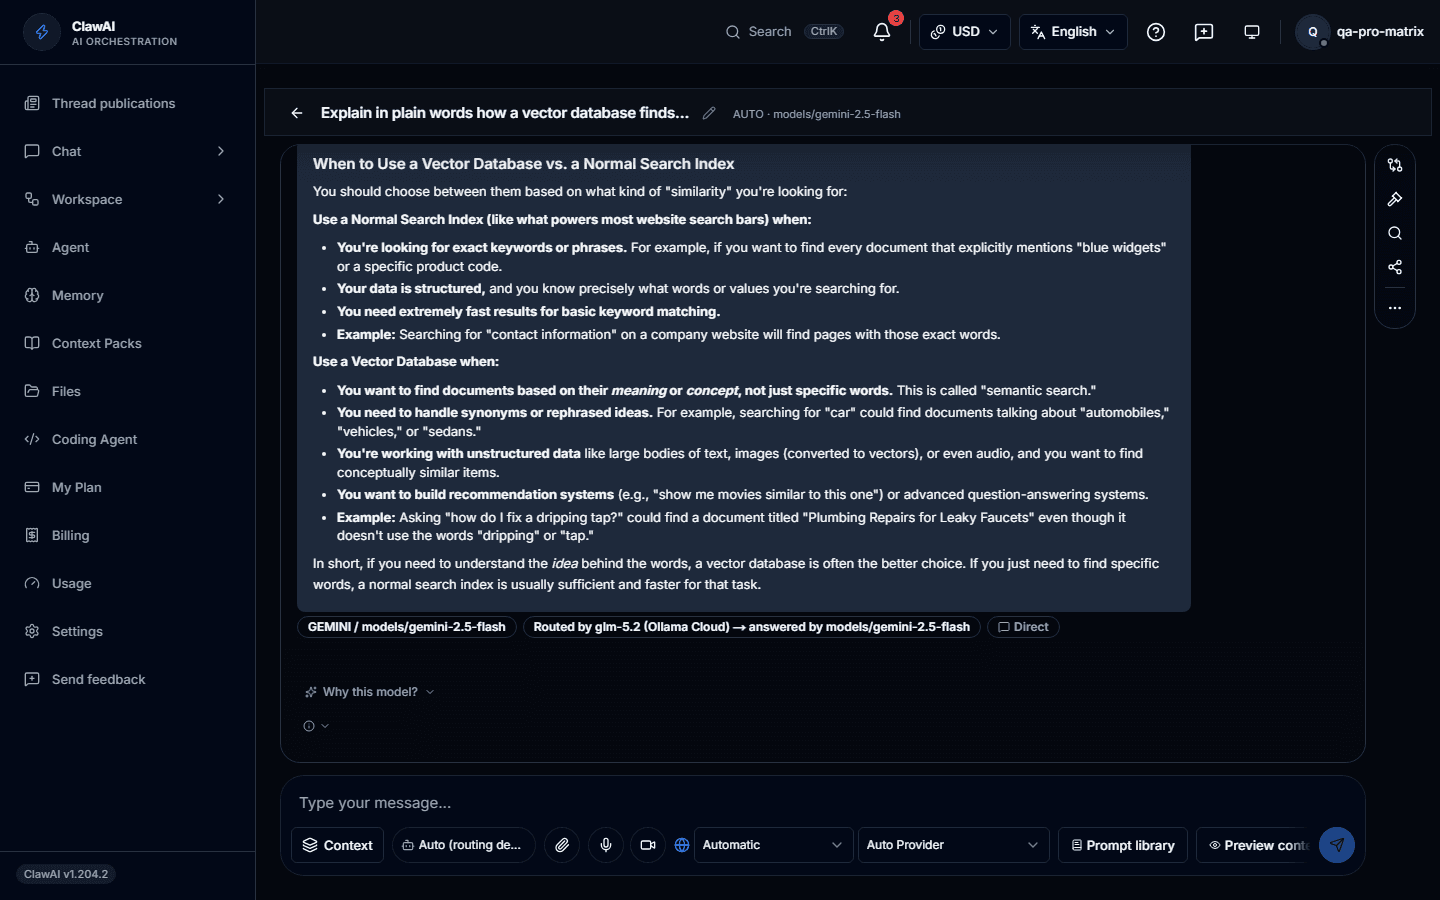
Chaque réponse indique quel modèle l’a rédigée et pourquoi.
Choisissez un concept
- Comment les modèles de langage génèrent des réponsesComment une requête devient des tokens, des probabilités puis une réponse générée.
- Que sont les tokens en IA ?L’unité qu’un modèle lit et écrit réellement, et pourquoi un chiffre exact exige son propre tokenizer.
- Que contrôlent la température et le top-p ?Ce que la température et le top-p changent vraiment dans une réponse — et ce qu’ils ne peuvent pas changer.
- Que sont les embeddings ?Comment un texte devient un vecteur de nombres, et pourquoi cela rend possible la recherche par sens.
- Prompting, RAG et fine-tuning : quelle différence ?Trois solutions différentes pour trois problèmes différents, et pourquoi beaucoup de produits n’ont jamais besoin de la troisième.
- Comment fonctionne vraiment l’appel d’outils en IA ?Le modèle n’exécute jamais rien lui-même — il propose un appel, et votre application décide de la suite.
- Que sont les sorties structurées en IA ?Demander du JSON à un modèle est une requête ; seuls certains mécanismes garantissent vraiment qu’il correspond à votre schéma.
- Pourquoi l’IA hallucine-t-elle ?Pourquoi un modèle énonce une réponse fausse avec la même assurance qu’une bonne — et ce qui réduit vraiment ça.
- Qu’est-ce que l’IA multimodèle ?Utiliser plusieurs modèles dans un même flux plutôt que de s’enfermer dans un seul.
- Qu’est-ce que l’orchestration de LLM ?La couche qui décide quel modèle s’exécute, dans quel ordre et ce qu’il advient du résultat.
- Qu’est-ce que le routage de modèles IA ?Envoyer chaque requête à un modèle choisi selon la tâche, le coût, la confidentialité ou la latence.
- Qu’est-ce que le repli entre modèles ?Ce qui doit se passer quand le premier modèle tombe, est limité ou refuse.
- Qu’est-ce que le consensus entre modèles IA ?Poser la même question à plusieurs modèles et traiter leur accord comme un signal.
- Qu’est-ce que le meilleur de N ?Produire plusieurs réponses candidates et garder la meilleure.
- Qu’est-ce qu’un juge IA ?Faire noter par un modèle les réponses des autres, et là où cela échoue.
- Qu’est-ce que la vérification des réponses IA ?Contrôler une réponse avec autre chose que le modèle qui l’a produite.
- Qu’est-ce qu’une fenêtre de contexte ?La mémoire de travail d’une seule requête, et pourquoi ce n’est pas de la mémoire.
- Qu’est-ce que la génération augmentée par récupération ?Retrouver vos propres documents et les placer devant le modèle.
- Qu’est-ce que la mémoire d’un assistant IA ?Ce qui persiste entre les conversations, et ce que cela coûte.
- Que sont les packs de contexte ?Des ensembles de contexte réutilisables que vous joignez volontairement à une conversation.
- Qu’est-ce que l’IA locale ?Faire tourner un modèle sur du matériel que vous contrôlez, et ce que cela change vraiment.
- Que sont les modèles à poids ouverts ?Des modèles dont vous pouvez télécharger les poids — et ce qu’« ouvert » veut dire ou non.
- Qu’est-ce que l’IA auto-hébergée ?Héberger toute l’application vous-même, pas seulement le modèle.
- Ollama ou llama.cppDeux façons d’exécuter des modèles à poids ouverts en local, et à quoi sert chacune.
- IA cloud ou IA localeLe vrai compromis : capacité et confort contre contrôle et forme du coût.
- Agent IA ou chatbotLa différence entre vous répondre et agir à votre place.
- Comment évaluer des modèles d’IA pour son propre usageCe qu’il faut vraiment tester avant de confier votre travail à un modèle — pas un chiffre de classement.
- Comment lire les benchmarks d’IA sans se laisser tromperCe qu’un chiffre de benchmark mesure vraiment, et comment il peut vous induire en erreur avant même de commencer à tester.
- Qu’est-ce que l’injection de prompt ?Un texte qui ne vient pas de vous peut quand même donner des instructions au modèle — ce que cela signifie et pourquoi un modèle plus intelligent ne peut pas résoudre ça entièrement.
- Confidentialité et conservation des données d’IA, expliquéesCe qui arrive vraiment à ce que vous tapez dans un produit d’IA — qui le voit, si ça entraîne un modèle, et combien de temps ça reste.