
Guías
Guías: IA multimodelo, enrutado y orquestación
Explicaciones claras de las técnicas detrás de la IA multimodelo: enrutado, consenso, verificación, RAG, memoria y modelos de pesos abiertos en tu propio hardware.
Última revisión:
Míralo en la app
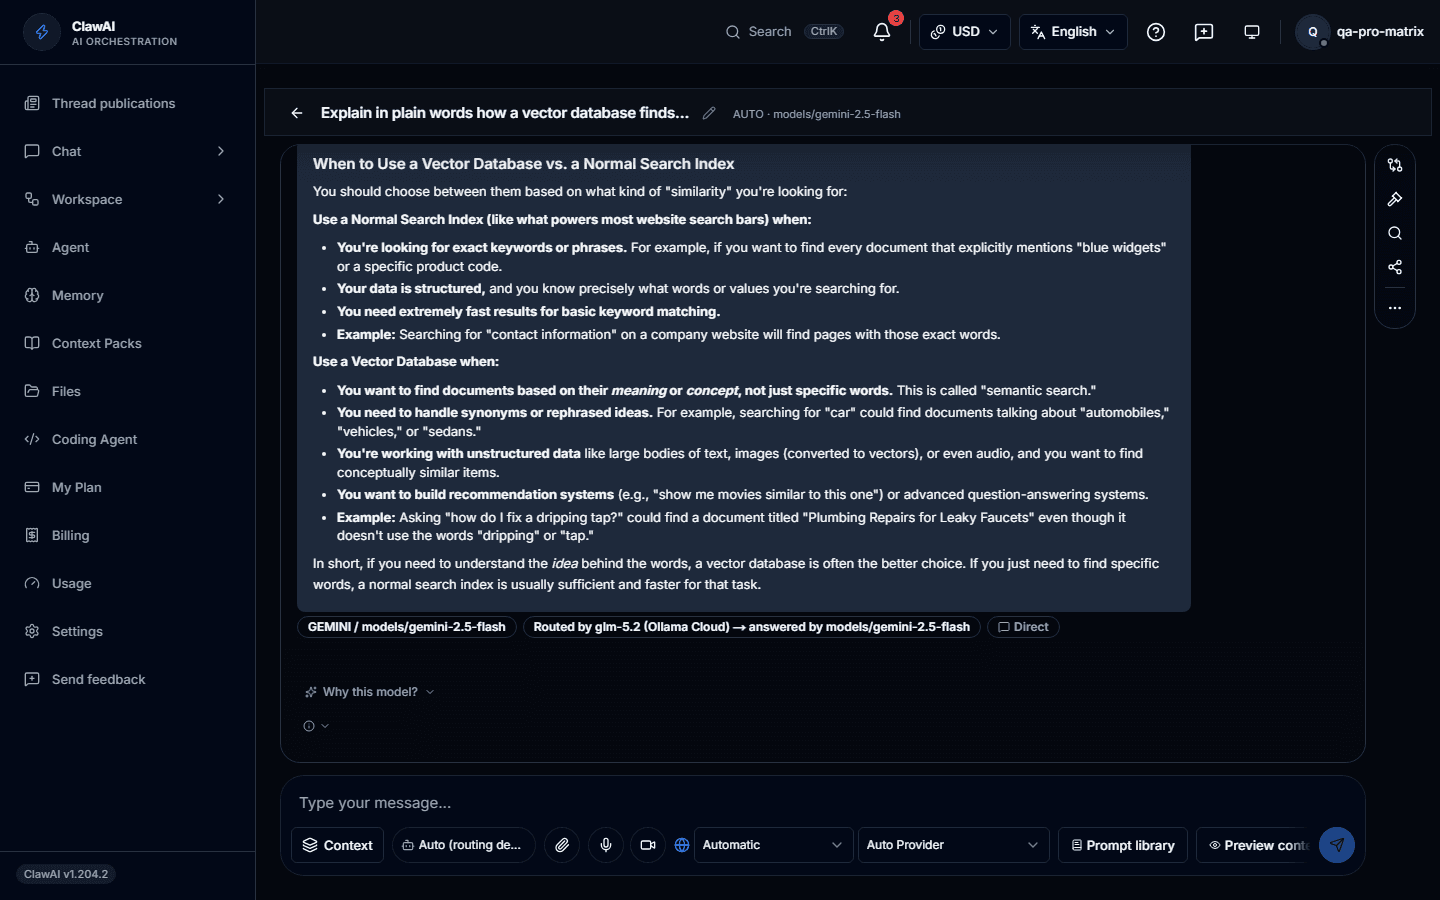
Cada respuesta muestra qué modelo la escribió y por qué.
Elige un concepto
- Cómo generan respuestas los modelos de lenguajeCómo un prompt se convierte en tokens, probabilidades y una respuesta generada.
- ¿Qué son los tokens de IA?La unidad que un modelo realmente lee y escribe, y por qué una cifra exacta necesita su propio tokenizador.
- ¿Qué controlan la temperatura y el top-p?Lo que la temperatura y el top-p realmente cambian en una respuesta, y lo que no pueden cambiar.
- ¿Qué son los embeddings?Cómo el texto se convierte en un vector de números, y por qué eso hace posible buscar por significado.
- Prompting vs. RAG vs. fine-tuning: ¿en qué se diferencian?Tres arreglos distintos para tres problemas distintos, y por qué muchos productos nunca necesitan el tercero.
- ¿Cómo funciona realmente la llamada a herramientas en IA?El modelo nunca ejecuta nada: propone una llamada, y tu aplicación decide qué pasa después.
- ¿Qué son las salidas estructuradas de IA?Pedirle JSON a un modelo es una petición; solo algunos mecanismos garantizan de verdad que encaje con tu esquema.
- ¿Por qué alucina la IA?Por qué un modelo afirma una respuesta equivocada con la misma seguridad que una correcta — y qué reduce eso de verdad.
- ¿Qué es la IA multimodelo?Usar varios modelos en un mismo flujo de trabajo en vez de casarte con uno.
- ¿Qué es la orquestación de LLM?La capa que decide qué modelo se ejecuta, en qué orden y qué pasa con el resultado.
- ¿Qué es el enrutado de modelos de IA?Enviar cada petición al modelo elegido por tarea, coste, privacidad o latencia.
- ¿Qué es el respaldo entre modelos?Qué debe pasar cuando el primer modelo se cae, se limita o se niega.
- ¿Qué es el consenso entre modelos de IA?Preguntar lo mismo a varios modelos y usar su acuerdo como señal.
- ¿Qué es el mejor de N?Generar varias respuestas candidatas y quedarse con la mejor.
- ¿Qué es un juez de IA?Usar un modelo para puntuar las respuestas de otros, y dónde falla eso.
- ¿Qué es la verificación de respuestas de IA?Contrastar una respuesta con algo distinto del modelo que la produjo.
- ¿Qué es una ventana de contexto?La memoria de trabajo de una sola petición, y por qué no es memoria.
- ¿Qué es la generación aumentada por recuperación?Recuperar tus propios documentos y ponerlos delante del modelo.
- ¿Qué es la memoria en un asistente de IA?Qué persiste entre conversaciones y cuánto te cuesta.
- ¿Qué son los paquetes de contexto?Paquetes de contexto reutilizables que adjuntas a una conversación a propósito.
- ¿Qué es la IA local?Ejecutar un modelo en hardware que controlas, y qué cambia de verdad.
- ¿Qué son los modelos de pesos abiertos?Modelos cuyos pesos puedes descargar, y qué significa y qué no «abierto».
- ¿Qué es la IA autoalojada?Ejecutar toda la aplicación por tu cuenta, no solo el modelo.
- Ollama frente a llama.cppDos formas de ejecutar modelos de pesos abiertos en local, y para qué sirve cada una.
- IA en la nube frente a IA localEl intercambio real: capacidad y comodidad frente a control y forma del coste.
- Agente de IA frente a chatbotLa diferencia entre responderte y hacer algo por ti.
- Cómo evaluar modelos de IA para tu propio usoQué probar de verdad antes de confiarle tu trabajo a un modelo — no un número de una clasificación.
- Cómo leer los benchmarks de IA sin dejarte engañarQué mide realmente un número de benchmark, y las formas en que puede engañarte antes incluso de empezar a probar.
- ¿Qué es la inyección de prompts?Un texto que no es tuyo puede darle instrucciones al modelo igualmente — qué significa eso y por qué un modelo más listo no puede resolverlo del todo.
- Privacidad y retención de datos de IA, explicadasQué pasa realmente con lo que escribes en un producto de IA — quién lo ve, si entrena un modelo, y cuánto tiempo se queda ahí.