
Modellanbieter
Lokale KI-Modelle mit offenen Gewichten in ClawAI
Betreiben Sie Modelle mit offenen Gewichten selbst mit Ollama oder llama.cpp über ClawAI, statt Anfragen an einen Cloud-Anbieter zu senden. Was der Mechanismus ist und wie er sich von den Cloud-Anbietern auf dieser Seite unterscheidet.
Alle Anbieter · Zuletzt geprüft:
In der App ansehen
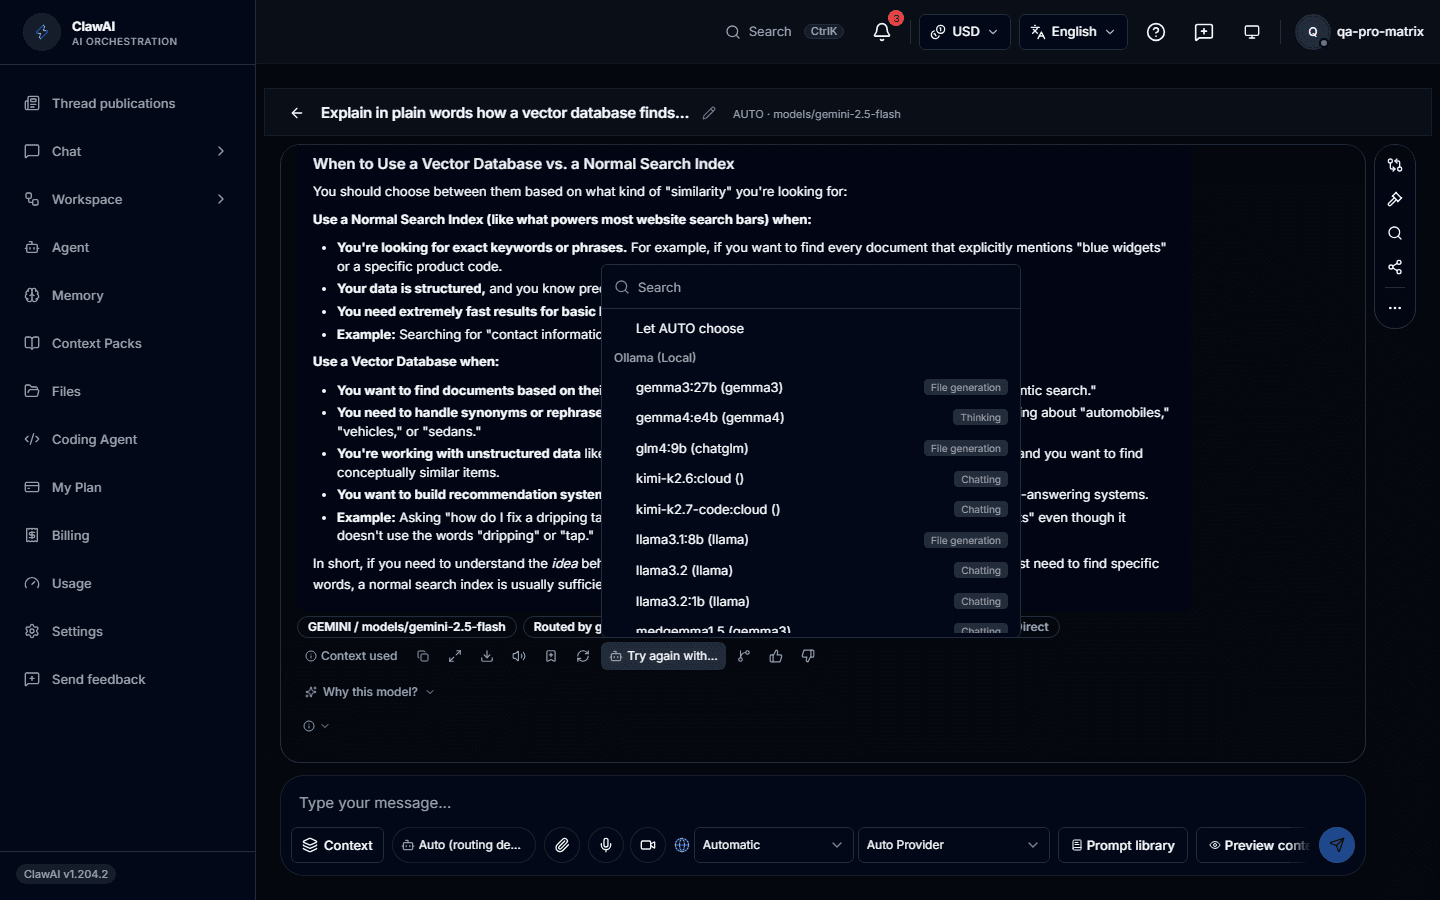
Wähle ein Modell selbst oder lass AUTO wählen.
Modelle, an die ClawAI routen kann
GLM 5.3
GLM 5.3 Flash
GLM 5.2
Mistral Large 4
Nemotron 3 Super
Nemotron 3 Ultra
Beam
clef:27b
Deepseek v4 pro:0813
Deepseek v4.1 Flash
Deepseek v4.1 flash:1017
gemma4:31b
GPT oss:120b
GPT oss:20b
Kimi k2.6
Kimi k2.7 Code
Kimi k3
Kimi k3.1 Pro
Mimo v2.6 Flash
Mimo v2.6 Pro
Minimax m3
Minimax m3.1 Flash
Muse Spark Open
Diese Liste wird live aus den Modellen gelesen, an die ClawAI derzeit weiterleiten kann. Sie ändert sich daher, sobald Anbieter angebunden oder Modelle eingestellt werden. Aktuellen Katalog auf der Preisseite prüfen
Was das lokale Ausführen eines Modells tatsächlich ändert
Ein Cloud-Anbieter auf dieser Seite betreibt ein Modell auf eigener Infrastruktur und berechnet pro Anfrage. Ollama und llama.cpp laden stattdessen ein Modell mit offenen Gewichten auf Hardware, die Sie kontrollieren — Ihre eigene Maschine oder einen Server, den Sie betreiben —, sodass die Anfrage diese nie verlässt. Das ändert, wer die Anfrage sehen kann, nicht, wozu das Modell fähig ist; ein lokal ausgeführtes Modell mit offenen Gewichten ist etwas grundlegend anderes als jeder der andernorts in dieser Gruppe aufgeführten Cloud-Anbieter, kein direkter Ersatz für einen von ihnen.
Ollama und llama.cpp sind zwei unterschiedliche Werkzeuge
Beide sind echte ClawAI-Connectoren, eignen sich aber für unterschiedliche Situationen — Ollama setzt auf einfaches Herunterladen und Ausführen eines Modells mit sinnvollen Standardeinstellungen, während llama.cpp direktere Kontrolle darüber gibt, wie ein Modell ausgeführt wird, auf Kosten von mehr manueller Einrichtung. Der vollständige Vergleich befindet sich unter Ollama vs. llama.cpp, unten verlinkt, statt hier wiederholt zu werden.
Auswahl, welches Modell mit offenen Gewichten ausgeführt werden soll
Diese Seite nennt bewusst kein bestimmtes Modell mit offenen Gewichten, weil sich das Feld schneller bewegt, als eine statische Seite es verfolgen kann, und eine veraltete Empfehlung schlimmer ist als keine. Was ist lokal-first KI, unten verlinkt, erklärt Modelle mit offenen Gewichten und die Abwägung gegenüber Cloud-Anbietern ausführlicher, als es eine Produktseite tun sollte.
Häufig gestellte Fragen
- Kostet lokale KI über ClawAI etwas?
- ClawAI berechnet für ein lokal ausgeführtes Modell keinen Preis pro Token, wie es das für einen Cloud-Anbieter tut, da kein Cloud-Anbieter abgerechnet wird — die Kosten sind die Hardware, die Sie bereits betreiben. Prüfen Sie das aktuelle Planverhalten auf der Preisseite.
- Welches Modell mit offenen Gewichten sollte ich ausführen?
- Diese Seite empfiehlt keines — siehe was ist lokal-first KI, unten verlinkt, für eine Herangehensweise an diese Entscheidung, da das richtige Modell von Ihrer Hardware und Aufgabe abhängt, in einer Weise, die eine statische Seite nicht verantwortungsvoll verfolgen kann.
- Ist ein lokal ausgeführtes Modell genauso leistungsfähig wie ein Cloud-Modell?
- Das hängt vollständig vom jeweiligen Modell mit offenen Gewichten und Ihrer Hardware ab, und diese Seite wird dazu keine pauschale Aussage treffen. Siehe wie man KI-Modelle bewertet, unten verlinkt, um dies für Ihre eigene Arbeitslast zu prüfen.
Probieren Sie es selbst aus, statt uns zu glauben
Die Ollama- und llama.cpp-Connectoren von ClawAI sind echte, ausgelieferte Anbindungen — der Modus „Nur lokal“ hält jede Anfrage auf Hardware, die Sie kontrollieren.