
文章
文章:多模型 AI、路由与编排
通俗解释多模型 AI 背后的一整套技术——路由、共识、N 选一最优、验证、RAG、记忆、上下文包,以及在自有硬件上运行开放权重模型,聚焦实际使用中最容易犯难的取舍。
最近核实:
在应用中查看
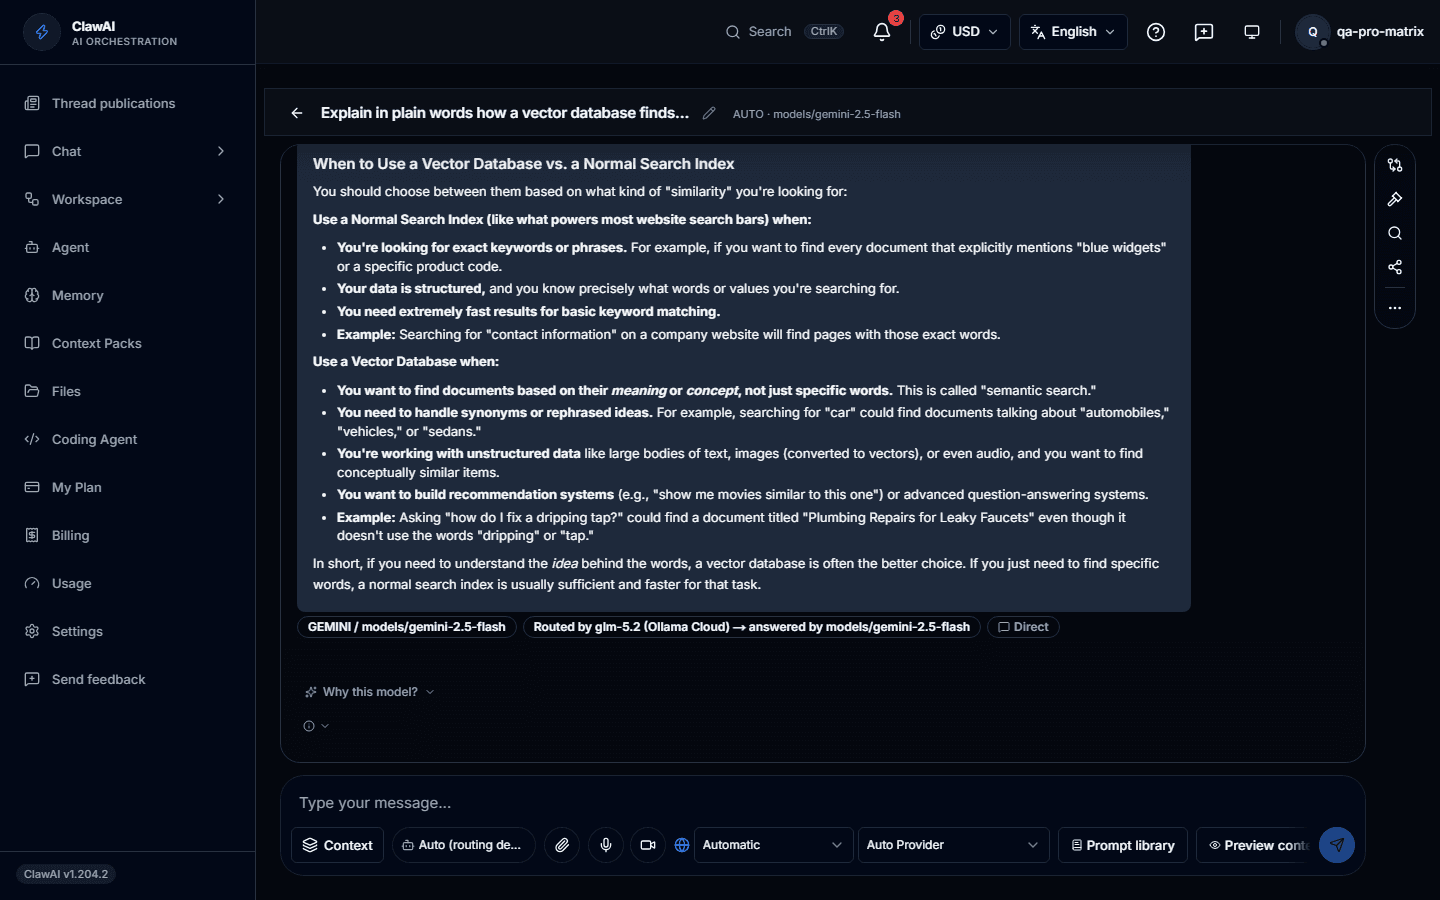
每个回答都会显示由哪个模型撰写以及原因。
选一个主题
- 语言模型如何生成回答提示词如何变成词元、概率,最终形成生成式回答。
- AI 词元是什么?模型真正读取和写出的单位,以及为什么精确数字需要它自己的分词器。
- Temperature 和 top-p 控制什么?Temperature 和 top-p 到底能改变一条回答的哪些方面——以及它们改变不了什么。
- 嵌入(Embedding)是什么?文本如何变成数字向量,以及这如何让按含义搜索成为可能。
- Prompting、RAG 与 fine-tuning:区别是什么?三种不同的解法,对应三种不同的问题,以及为什么很多产品从来都用不上第三种。
- AI 工具调用到底是怎么运作的?模型从来不会执行任何操作——它只是提出一次调用,由你的应用决定接下来发生什么。
- AI 的结构化输出是什么?向模型要求 JSON 只是一个请求;只有部分机制才能真正保证它符合你的结构定义。
- AI 为什么会产生幻觉?为什么模型会用和答对时同样的自信说出错误答案——以及真正能降低这一点的方法。
- 什么是多模型 AI?在一个工作流里用多个模型,而不是固定用一个。
- 什么是 LLM 编排?决定哪个模型运行、以什么顺序运行、输出如何处理的那一层。
- 什么是 AI 模型路由?按任务、成本、隐私或延迟,把每个请求发给挑选出来的模型。
- 什么是模型间的回退?第一个模型宕机、被限速或拒绝时应该发生什么。
- 什么是 AI 模型共识?把同一个问题问多个模型,把它们的一致意见当作信号。
- 什么是「N 选一最优」?生成多个候选答案,留下最好的一个。
- 什么是 AI 裁判?用一个模型给其他模型的答案打分——以及这在哪里会失效。
- 什么是 AI 答案验证?用生成答案的模型以外的东西来核实这个答案。
- 什么是上下文窗口?单次请求的工作记忆——以及它为什么不是记忆。
- 什么是检索增强生成?检索你自己的文档,摆到模型面前。
- 什么是 AI 助手的记忆?对话之间会留下什么,代价是什么。
- 什么是上下文包?你有意附加到对话中的、可重复使用的上下文包。
- 什么是本地 AI?在你自己掌控的硬件上运行模型——实际会改变什么。
- 什么是开放权重模型?权重可以下载的模型——「开放」意味着什么,不意味着什么。
- 什么是自托管 AI?自己运行整个应用,而不只是模型。
- Ollama 还是 llama.cpp本地运行开放权重模型的两种方式,各自适合什么场景。
- 云端 AI 还是本地 AI真正的取舍:能力与便利,对上掌控力与成本形态。
- AI 智能体还是聊天机器人回答你和替你行动之间的区别。
- 如何为自己的用途评估 AI 模型把工作交给一个模型之前,真正该测试的是什么——而不是排行榜上的一个数字。
- 如何阅读 AI 跑分而不被误导一个跑分数字真正衡量的是什么,以及它在你开始测试之前就可能误导你的地方。
- 什么是提示词注入?不是你写的文本仍然可以给模型下指令——这意味着什么,以及为什么更聪明的模型也无法完全解决它。
- AI 数据隐私与保留期解析你在 AI 产品里输入的内容究竟会发生什么——谁能看到、是否会用来训练模型,以及会保留多久。